近日,我院在视频时序语句定位与多模态学习领域取得新进展,相关研究成果被IEEE Transactions on Multimedia(TMM)录用发表。TMM是多媒体技术领域具有重要影响力的国际学术期刊,被中国计算机学会(CCF)列为计算机图形学与多媒体领域A类推荐期刊;按2025年3月升级版中科院期刊分区表,TMM位列计算机科学大类1区并被标记为TOP期刊。此次研究成果被TMM录用发表,体现了我院在视频内容理解、跨模态学习、智能媒体分析与计算机视觉等方向上的持续探索和科研积累。
论文题目:EFIN: A Novel Enhanced Feature Interaction Network for Temporal Sentence Grounding in Videos。
随着互联网视频和移动终端的快速发展,海量视频中往往同时包含目标信息与大量无关内容。视频时序语句定位旨在根据自然语言查询,在未裁剪视频中找出语义最相关片段的起止边界。该任务不依赖预先设定的固定类别,要求模型既能理解视频与文本各自的语义,又能建立两种模态之间的准确对应关系,因此是视频检索、智能问答和人机交互等应用中的基础问题。
现有视频时序语句定位方法虽然能够利用视频与文本特征生成候选片段并完成跨模态匹配,但对模态内部深层语义关系的挖掘仍不充分,视频与文本之间的细粒度对齐能力也有待提升。此外,候选片段与多模态特征之间的信息交互不够充分,易导致候选片段的语义表征能力受限,进而影响复杂场景下目标片段的准确定位。如何在强化单模态语义表达的同时,建立更有效的跨模态关联,并将增强后的信息充分融入候选片段,仍是该任务需要解决的关键问题。
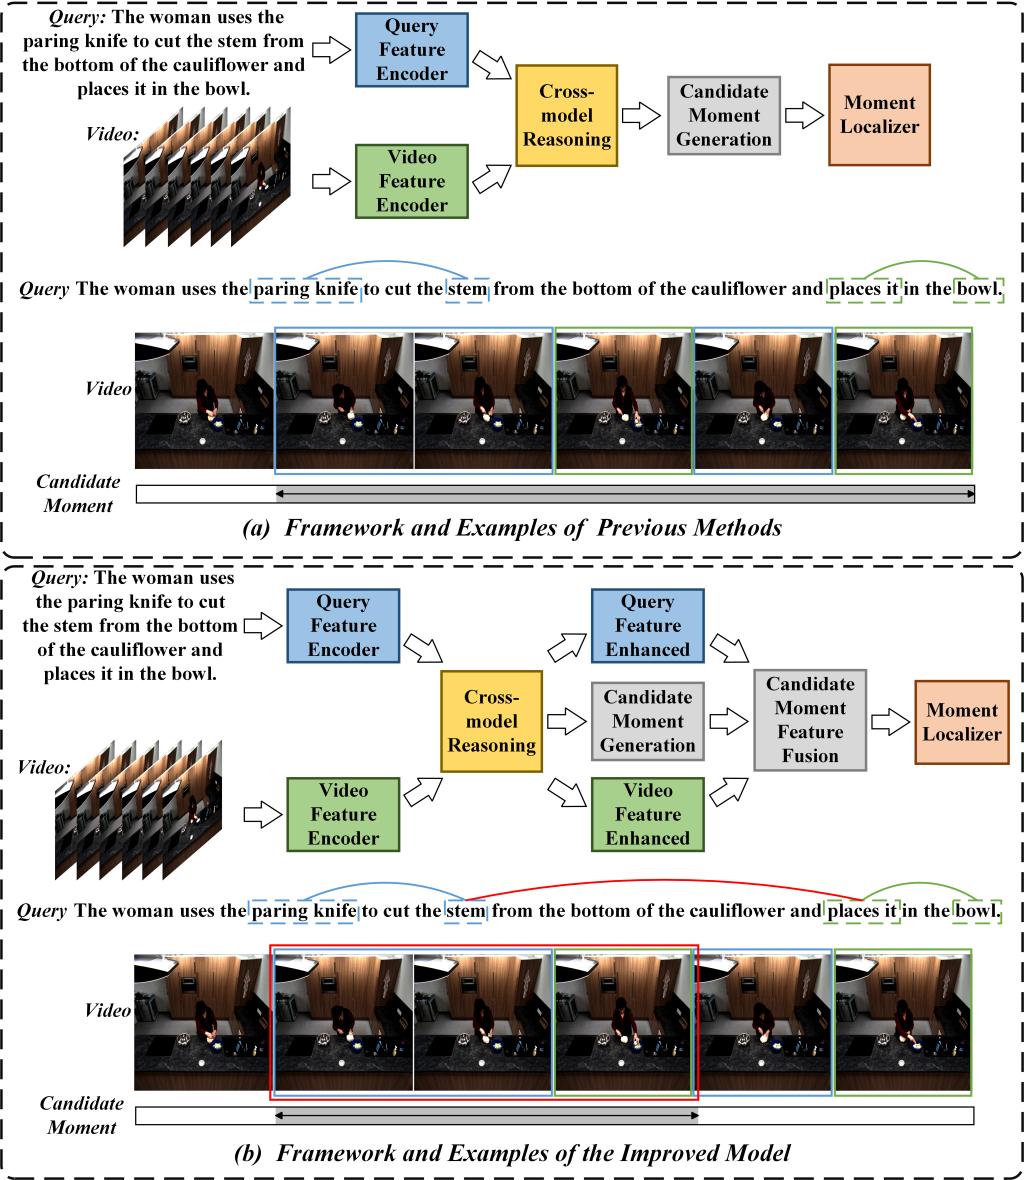
图1现有方法的特征交互与候选片段融合不足,以及本文所提方案示例
针对视频时序语句定位中模态特征表征不足、跨模态对齐不充分及候选片段信息融合有限等问题,论文提出了增强特征交互网络EFIN。该方法在基础特征和候选片段生成的基础上,利用增强特征编码器挖掘单模态语义并强化跨模态对齐,再通过信息融合模块将增强信息融入候选片段,提升对片段内容、边界信息及多模态上下文的联合建模能力。在四个公开基准数据集上的实验结果表明,EFIN在多项评价指标上取得了非常有竞争力的性能,验证了所提方法在提升候选片段表征能力和时序定位精度方面的有效性。
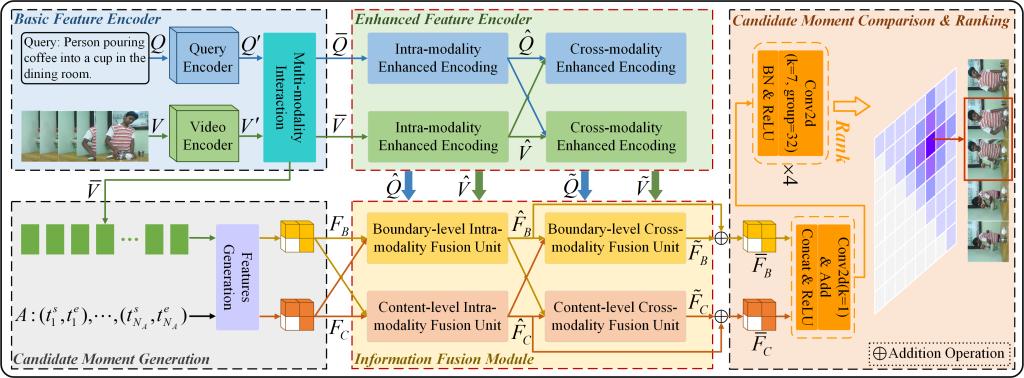
图2 EFIN增强特征交互网络总体框架
该论文第一作者为我院温显斌教授和高赞教授指导的23级博士研究生胡崇旭,由我院视觉感知与媒体安全创新团队与哈尔滨工业大学(深圳)等单位学者合作完成。论文具体信息如下:Hu, Chongxu and Wen, Xianbin and Zhao, Yibo and Ma, Chunjie and Guan, Weili and Wang, Riwei andGao, Zan,EFIN: A Novel Enhanced Feature Interaction Network for Temporal Sentence Grounding in Videos, in IEEE Transactions on Multimedia, vol. 28, pp. 3518-3531, 2026
近年来,学院持续面向人工智能与多媒体信息处理交叉前沿,推进智能算法、视觉理解与自然语言处理的深度融合。未来,学院将继续围绕视频内容理解、多模态学习和智能交互等关键科学与技术问题开展研究,加强与国内外高校和科研机构的学术交流与科研合作,不断提升相关领域的科研创新能力和学术影响力。